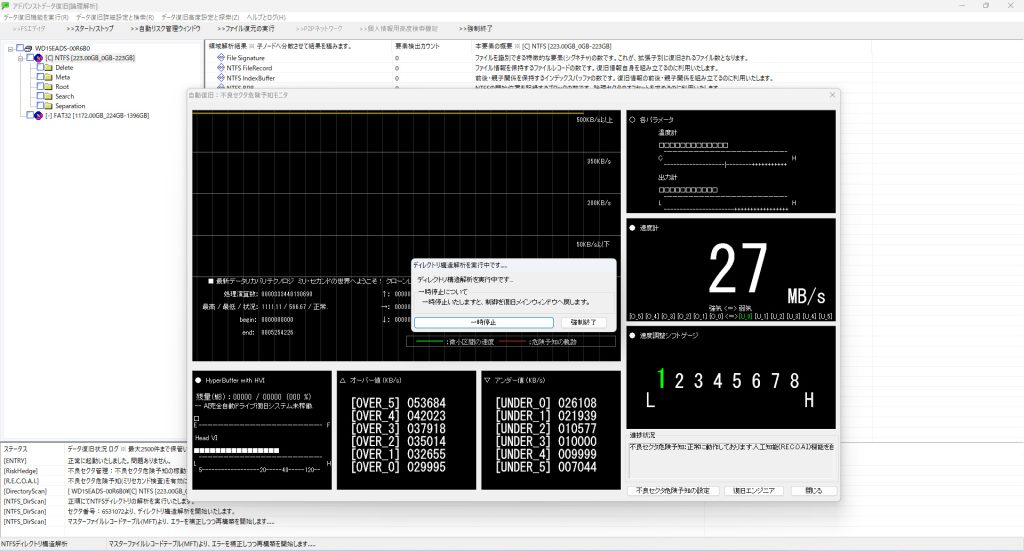

RAIDに対する復旧 Data_Array&Restoration技術
ストライプサイズで分割することで、各データを分散することにより速さや耐久性向上を図ったものがRAIDとなります。
このとき「リビルド」に失敗しデータ復旧をご相談いただく事が大変多い傾向です。
このリビルドとは「正常な状態に戻す作業」を指しますが、確実な成功は保証されておりません。
ドライブには、徐々に劣化する性質があります。
徐々に劣化して故障した場合は、リビルドを必要とした時点で他のドライブにも劣化による整合性が壊れている状況となっており結果的にリビルドに失敗します。
このような性質を生み出している原因は「ビット腐敗」です。
【FromHDDtoSSD不良セクタ修復】ビット腐敗: 特殊な形態を取る不良セクタを解説
RAIDの動作モード
RAID-0(ストライピング)

主に速度向上を目的とした構成で、データ保護機能は一切ありません。
一定のストライプサイズでデータを複数のドライブに分散させることで高速化を実現します。
ただしいずれか1台のドライブが故障した場合は全データへのアクセスが不可能となります。
そこで、RAIDの基本的な構成の一つである、このストライピングの詳細ついて見ていきます。
ストライピングとは、複数のドライブに対して決められたストライプサイズごとにデータを分散し、交互に読み書きしていく方式です。
複数のドライブへ処理を分散できるため、読み書き性能の向上が期待できます。
特に、連続した大きなデータを扱う場合には単体ドライブよりも高速に処理できることがあります。
しかし、その一方で、ストライピングには冗長性がありません。
つまり、構成しているドライブのうち1台でも故障すると全体のデータ構造が崩れてしまいます。
その結果すべてのデータにアクセスできなくなる可能性があります。
このように、複数台のドライブを使って性能を高める一方で1台の故障によって全体を失う危険がある。それがストライピング「いわゆるRAID 0」です。
そのため、データ保護を目的としてRAID 0を選ぶことはありません。
RAID 0は、あくまで速度や容量効率を重視する構成です。
ただし、RAIDはもともとバックアップではありません。
そのため、別媒体へのバックアップをしっかり確保したうえで速度を重視してRAID 0を運用する。
そのような方針であれば、RAID 0も十分に成立する構成です。
この違いを理解しておくことが、RAIDを正しく扱ううえで非常に重要です。
RAID-1(ミラーリング)

速度面は単独ドライブと同等ですがデータ保護性に優れた構成です。
すべてのデータをセクタ単位で複製(ミラー)するため一台のドライブが故障してもデータは残されたドライブから取得できます。
ただしビット腐敗などによりミラー構成でも正常にリビルドできないケースもあり過信は禁物です。よって、バックアップとしては機能しません。
とりわけRAIDの中でもデータ保護装置と勘違いされやすいのがミラーリングです。
ミラーリングは、確かに複数のドライブへ同じ内容を書き込む方式です。
「RAIDではOSと各ドライブの間にRAIDコントローラやRAID管理層が入る」という点です。
OSはRAIDコントローラを通してデータを読み書きしておりその先にある複数のドライブをどのように扱うかは、RAID側の管理に委ねられています。
構成情報・メタデータ・書き込み順序・同期状態・ディスク番号・管理領域などが関係するためです。
それゆえに、ミラーリングは「もう1台に同じデータがあるから安心」という仕組みではありません。
どのドライブを有効なメンバーとして扱うのか。
どのドライブを基準に再構成するのか。同期状態に問題がないのか。
その判断にはRAID構成に関する専門的な知識が必要になります。この点がバックアップとの大きな違いです。
バックアップであれば別媒体に保存されたデータを通常のファイルとして直接参照できることが重要になります。
一方RAIDミラーリングではRAID構成や管理情報を正しく解釈しなければデータへ安全にアクセスできないことがあります。
つまりミラーリングはドライブ故障時の稼働継続性を高める仕組みです。
しかし、失われたデータを簡単に戻すためのバックアップではありません。
RAIDを正しく扱うにはミラーリングであっても過信せずに別媒体へのバックアップを必ず用意しておくことが重要です。
RAID-5(パリティ付きストライピング)

読み取り速度は向上しますが書き込み時にはパリティ計算が加わるため若干の速度低下が生じます。
データ保護性は限定的で1台のドライブまでしか故障を許容できません。
これはRAID-0構成にパリティ(排他的論理和)を加えた形でありパリティをもとに失われたデータを復元します。
1台のドライブを失っても稼働を継続できる分散型のドライブ構成として登場するのがRAID 5です。
RAID 5は「パリティ付きストライピング」と呼ばれる方式です。
ストライピングによって複数のドライブへデータを分散しながら同時にパリティ情報を記録します。
このパリティ情報を利用することで、構成ドライブのうち1台が故障しても失われたデータを計算によって復元できます。
これがRAID 5の大きな利点です。ところが、ここに大きな欠点もあります。
RAID 5は、1台の故障には対応できます。
しかし、1台が故障した時点で残っている他のドライブには高い完全性が求められます。
故障した1台を補うためには残存ドライブから正しくデータを読み出せることが前提になります。
もし他のドライブにも不良セクタや読み取り不安定な領域が広がっていた場合、どうなるでしょうか。
故障したドライブの情報を復元するためのパリティ計算による再構成が成立しません。
その結果リビルドが失敗し、RAID全体の整合性が崩れます。
特に、長期間運用されていたRAID環境では表面化していない不良セクタやビット腐敗が残存ドライブ側に存在している場合があります。
普段はアクセスされないため問題が見えていなかった領域がリビルド時に一気に読み出されることで初めて異常として表面化することもあります。
そのため、RAID 5のリビルドに過度な期待をするのは危険です。
RAID 5を運用する場合は、定期的なドライブ検査・整合性チェック・別媒体へのバックアップが不可欠です。
RAID 5は便利な構成ですが万能ではありません。
稼働時間を延ばすための仕組みであると理解しリビルドに頼り切らない運用が重要になります。
RAID-6(二重パリティ付きストライピング)

RAID-5の強化版で二重のパリティ情報により最大2台のドライブ故障に耐えることができます。
安全性を高めたい環境で有効です。
構成されているドライブのうち最大2台までの故障に耐えられるようにしたものがRAID 6です。
RAID 6では2種類のパリティ情報を分散して保持することで最大2台までのドライブ故障に耐えられるように設計されています。
ここで重要なのは、「1台まで」と「2台まで」の差です。
これは単に、同時に2台壊れる確率に備えるというだけではありません。
RAID 5より余裕を持って対応できる可能性が高まるという点が大きいのです。
ただし、RAID 6であっても、バックアップの代わりにはなりません。
RAID 6は、あくまでドライブ故障時の稼働継続性を高めるための仕組みです。
誤削除・ランサムウェア・ファイルシステム破損・RAID構成情報の破損・装置全体の故障などには対応できません。
データを守るには、定期的なドライブ検査・整合性チェック・そして別媒体へのバックアップを組み合わせた運用が重要になります。
RAID-10(1+0 または 0+1)

RAID-0とRAID-1を組み合わせた構成で高速性と耐障害性の両立が可能です。
ただし使用可能な容量は総ドライブ容量の半分となるためコスト効率はあまり高くありません。
構成時はミラーリングした構成にストライピングを施す「1+0」形式を推奨します。
(「0+1」は耐久性に劣ります)
ミラーリングとストライピングを組み合わせることで、両方の利点を得ようとする構成があります。
それが、RAID 10やRAID 01です。
RAID 10は、ミラーリングした組をさらにストライピングする構成です。
一方RAID 01は、ストライピングした組をさらにミラーリングする構成です。
いずれもミラーリングによる冗長性とストライピングによる速度向上を組み合わせようとする考え方です。
ただし、この方式には大きな欠点があります。それは、実効容量が半分になることです。
そして、ここでも重要なのは「RAIDはバックアップではない」という点です。
RAID 10やRAID 01であっても、誤削除・ランサムウェア・ファイルシステム破損・RAID構成情報の破損、装置全体の故障には対応できません。
ミラーリングとストライピングを組み合わせたとしても、それは稼働継続性や性能を高めるための構成です。
最終的にデータを守るには別媒体へのバックアップを必ず用意する必要があります。
スパニング(JBOD)

複数のドライブを組み合わせる方式の一つに、スパニングがあります。
スパニングとは、ストライプサイズを設けず複数のドライブをそのまま順番につなげて一つの大きな領域として扱う方式です。
ストライピングのように複数のドライブへ同時に分散して読み書きするわけではありません。
そのため基本的には読み書き性能の向上は期待できません。
またミラーリングやパリティのような冗長性もありません。
スパニングは、比較的古いRAID装置や簡易的なストレージ装置で使われていた方式ですが最近ではあまり見かけなくなりました。
複数のドライブ容量を単純に連結する構成で速度や耐久性の向上は一切ありません。
使用可能容量が増えるだけで信頼性には乏しい構成です。
データスキャン作業に関しましては、「並列同時解析」による一括処理です。
RAIDで重要となるデータ整合性検査はRAID専用に開発いたしております。
並列処理に融合させた検査となりましてバッファを検査へ流用し2度目のバッファ処理を防ぎます。
別処理で乗せてしまうとバッファへの2度読みが発生し時間的に大きな不利となります。
ドライブ取出作業>>初期診断作業>>損傷分布検査作業
A, データスキャン作業(必要台数へ実施)>>データ整合性検査
B, クリーンルーム作業>>データスキャン作業(必要台数へ実施)>>データ整合性検査
ドライブ取出作業
データ復旧の実施に必要となる全ドライブをRAID装置から取り出す作業となります。
全てのドライブを調査いたしますので「全て」取り外します。
初期診断作業
- ドライブに負担がないよう診断を実施いたします。
- スキャンが通常(レベル1~2、クラスタ)レベルで可能か判断いたします。
- 2の過程で不可判定:別の手法(セクタ単位レベル)を試します。
- 3の過程で不可判定:クリーンルーム作業を検討します。
損傷分布検査作業
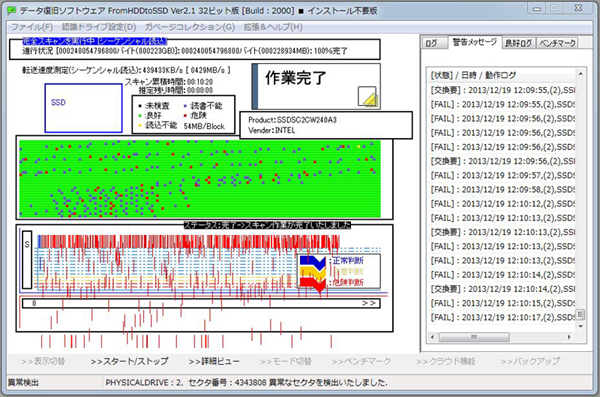
損傷度合いの全体分布を予測し作成します。
この結果からクリーンルーム作業の必要性を検討します。
分布図より読み取れる範囲が小さいと推測される場合はクリーンルーム作業により復活させる必要性ありとなりますし複数のドライブで一つのアレイ(データ)を成しておりますので最善の選択すなわちどのドライブを回復させるか判断を仰ぐ必要が必ず生じます。
複数のミラーリングで両方破損の場合は損傷分布検査作業にて状態の良い1台が選び出されます。
状態の良い方からデータを復旧する作業により、復旧率の点でお客さまのご期待にお応えいたします。
[損傷分布に関して]
電源を入れているだけでも広がって行く傾向がありまして各ドライブの損傷度合いを見抜くのに必須な作業となります。
実際には数値化ではなくグラフ化してしまいます。その方が着実に分かるためです。選定されたドライブに対し復旧方針を立てます。
それから最適な作業(クリーンルーム作業・データスキャン作業)を実施いたします。
[物理障害重度] クリーンルーム作業
- [少しでも最良な条件を作る]
HDDに付着するホコリを除去いたします。 - [表面検査]
トップカバーの開封に着手しプラッタ表面の状態を検査します。(スキャンに応用します) - [破損個所回収]
正常動作を阻害する直接的な要因を全て取り除きます。(例:吸着したヘッド等) - [剥離した磁性体除去]
内部の汚れている個所(削られた磁性体)を除去しそれらを回収します。 - [内部部品交換]
破損した部品を全て取り除き正常品から取り外したものと交換します。 - [最終チェック]
全部品を再確認いたします。確認のちトップカバーを閉じで作業完了です。 - [ファームウェア修復]
状況によってはファームウェア系統の修復を実施します。
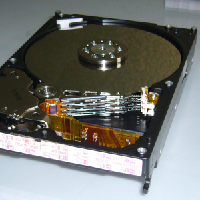
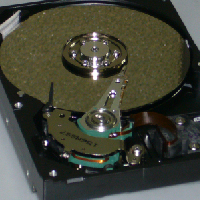
単独ドライブの場合と同じ作業を実施いたします。
複数のドライブを単につなげただけですのでその故障に関しましては1台ずつ別々に修復いたします。
もちろん損傷分布検査作業で必要ないと判断されたドライブには処置いたしません。
データスキャン作業, データ再構築作業
データスキャン以降を一括処理できるRAIDツール(並列同時解析)を独自開発いたしました。
現在RAIDのデータ復旧を着実に処理できる「並列同時解析」を独自に開発いたしました。
ドライブ型番別に「スキャンマップ(パターン)」を持ち概算的な調整がなされます。
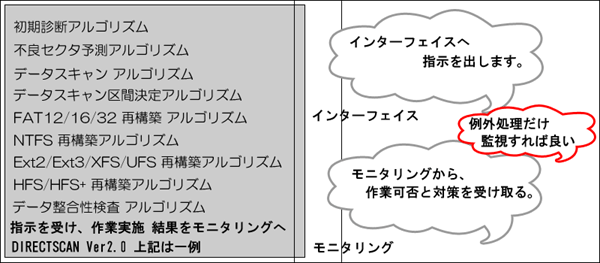
RAIDでは更に重要なデータ整合性検査
RAIDのデータ復旧にて主要となるのは「データ整合性検査」です。
データが化けていないかどうか独自の検査方法で確実に判断するものとなっております。
「データがバラバラで、ほとんど(一切)開かない状態で納品された」例などはこの検査が行われていないことを示します。
データリストにファイル名が存在してもこの検査がないとそのような場合も十分に考えられます。
この検査によりファイル名があってもほとんど開かないという状況を防ぐことができます。
コンピュータによるファイル自走検査で高クオリティおよびプライバシーを確保いたします。
以下「ファイル自動走査」にてファイル構成が正しいかどうか検査中です。